सूचना प्रौद्योगिकी प्रभाग

भारत के रजिस्ट्रार जनरल एवं जनगणना आयुक्त के कार्यालय (ORGI) ने वर्ष 1961 से भारत की दशकीय जनगणना के संचालन में महत्वपूर्ण भूमिका निभाई है। जनगणना कार्यों का दायरा और जटिलता बढ़ने के साथ-साथ, उनके प्रभावी संचालन के लिए प्रौद्योगिकी का महत्व भी बढ़ा है। सूचना प्रौद्योगिकी (IT) प्रभाग, ORGI की तकनीकी रीढ़ के रूप में कार्य करता है तथा जनगणना कार्यों को सहयोग प्रदान करने वाली डिजिटल प्रणालियों के डिजाइन, विकास और रखरखाव के लिए उत्तरदायी है। यह प्रभाग डेटा के प्रसंस्करण एवं प्रबंधन की देखरेख करता है, संगठन के आईटी अवसंरचना और डेटा की सुरक्षा सुनिश्चित करता है तथा प्रणालियों की विश्वसनीयता, दक्षता और सटीकता बनाए रखता है। इन कार्यों के माध्यम से, आईटी प्रभाग डिजिटल प्रक्रियाओं में सुधार करके और महत्वपूर्ण जनसांख्यिकीय जानकारी के सुरक्षित एवं कुशल संग्रहण, प्रसंस्करण, विश्लेषण तथा प्रसार को सक्षम बनाकर जनगणना कार्यों के क्रमिक आधुनिकीकरण में सहयोग प्रदान करता है। इसके प्रयास ORGI की तकनीकी क्षमताओं को सुदृढ़ करते हैं और इसके राष्ट्रीय दायित्वों के प्रभावी निर्वहन में सहायता प्रदान करते हैं।
2027 की जनगणना
भारत की जनगणना 2027 एक ऐतिहासिक मील का पत्थर है, क्योंकि देश पहली बार पूर्णतः डिजिटल माध्यम से जनगणना संबंधी आँकड़ों का संग्रहण करने जा रहा है। जनगणना कार्यों में आधुनिक प्रौद्योगिकी के निरंतर उपयोग के आधार पर, यह परिवर्तन आँकड़ों के संग्रहण, प्रसंस्करण और प्रसार की प्रक्रिया को अधिक सुव्यवस्थित बनाएगा। अपना उपकरण स्वयं लाएँ (Bring Your Own Device — BYOD) मॉडल के अंतर्गत, प्रगणक (Enumerators) ORGI द्वारा विकसित मोबाइल एप्लिकेशन के माध्यम से जानकारी दर्ज करने के लिए अपने Android या iOS स्मार्टफोन का उपयोग करेंगे। इस परिवर्तन से कार्य संचालन की दक्षता में सुधार, आँकड़ों की गुणवत्ता में वृद्धि तथा जनगणना कार्यों के तकनीकी आधार को और अधिक सुदृढ़ करने की अपेक्षा है।
जनगणना की कार्यप्रणाली की व्यापक रूपरेखा निम्नलिखित है:
-
आँकड़ों का संग्रहण निम्नलिखित दो माध्यमों से किया जा रहा है:
- स्व-गणना (Self Enumeration): आम जनता अपनी सुविधानुसार किसी भी स्थान से स्वयं अपनी जानकारी दर्ज कर सकेगी।
- मोबाइल एप्लिकेशन आधारित संग्रहण (Mobile Application Based): प्रगणक प्रत्येक घर का दौरा करेंगे और व्यापक एवं सटीक आँकड़ा संग्रहण सुनिश्चित करने के लिए मोबाइल एप्लिकेशन का उपयोग करके आवश्यक जानकारी एकत्र करेंगे।
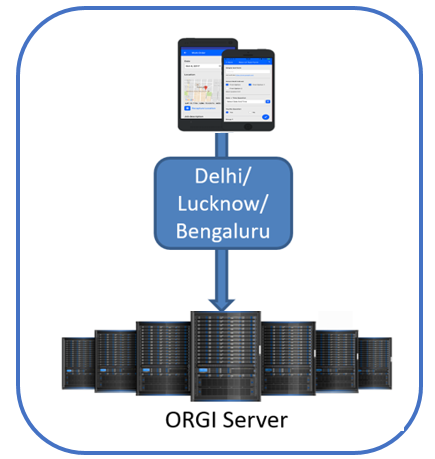
( स्व-गणना और मोबाइल एप्लिकेशन, दोनों माध्यमों से एकत्र किए गए आँकड़े प्रणाली द्वारा स्वतः ORGI के तीन डेटा केंद्रों में से किसी एक केंद्र को प्रेषित कर दिए जाएँगे। ये डेटा केंद्र दिल्ली, लखनऊ और बेंगलुरु में स्थित हैं। स्व-गणना (SE) और मोबाइल एप्लिकेशन, दोनों माध्यमों से प्राप्त आँकड़े स्वतः ORGI के तीनों डेटा केंद्रों में स्थानांतरित किए जाएँगे। डेटा की उपलब्धता और कार्यों की निरंतरता सुनिश्चित करने के लिए स्वचालित फेलओवर (वैकल्पिक प्रणाली पर स्वतः स्थानांतरण) तथा प्रतिदिन वृद्धिशील बैकअप (Incremental Backup) की व्यवस्था की जाएगी। स्व-गणना की प्रक्रिया के अंतर्गत एक विशिष्ट स्व-गणना पहचान संख्या (Self Enumeration ID — SEID) उत्पन्न होगी, जिससे प्रगणक घर-घर जाकर जानकारी के सत्यापन के दौरान संबंधित डेटा को पुनः प्राप्त कर सकेंगे। पुनः प्राप्त किया गया डेटा प्रगणकों के मोबाइल उपकरणों पर स्वतः भर जाएगा, ताकि वे उसकी जाँच, सत्यापन और आवश्यक जानकारी को पूरा कर सकें।)
जनगणना वेब पोर्टल (सीएमएमएस) के माध्यम से प्रबंधन और निगरानी: जनगणना प्रबंधन एवं निगरानी प्रणाली (Census Management and Monitoring System — CMMS) एक विशिष्ट वेब-आधारित पहल है, जिसे जनगणना की सभी प्रारंभिक एवं चालू गतिविधियों के प्रबंधन, समन्वय और वास्तविक समय में निगरानी के लिए स्थापित किया गया है। यह प्रणाली देश के सभी प्रशासनिक क्षेत्रों के स्थान संबंधी विवरणों का व्यापक अभिलेख रखती है तथा जनगणना पदाधिकारियों की नियुक्ति, प्रशिक्षण कार्यक्रमों, कार्य आवंटन, रसद एवं आवश्यक व्यवस्थाओं, क्षेत्रीय कार्यों की प्रगति और समेकित सारांशों की ऑनलाइन प्रविष्टि सहित विभिन्न परिचालन गतिविधियों से संबंधित जानकारी के लिए एक केंद्रीकृत भंडार के रूप में कार्य करती है। इन सभी कार्यों को एक ही मंच पर एकीकृत करके, CMMS संपूर्ण जनगणना प्रक्रिया के दौरान व्यवस्थित समन्वय, प्रभावी पर्यवेक्षण और समयबद्ध निगरानी को सक्षम बनाता है।
डाटा सुरक्षा:
ORGI के सर्वरों में डेटा के संग्रहण और प्रसारण से लेकर उसके भंडारण एवं प्रसंस्करण तक, डेटा जीवनचक्र के प्रत्येक चरण में सुदृढ़ सुरक्षा उपाय लागू किए गए हैं। इन उपायों का उद्देश्य डेटा की सुरक्षा करना, अनधिकृत पहुँच को रोकना तथा डेटा की गोपनीयता, अखंडता और उपलब्धता सुनिश्चित करना है:-
- अधिकृत पहुँच (Authorized Access): डेटा का संग्रहण केवल विधिवत पहचान किए गए और अधिकृत उपयोगकर्ताओं द्वारा किया जाता है। यह सुनिश्चित करने के लिए कि केवल अधिकृत कर्मचारी ही डेटा तक पहुँच सकें, पहुँच के स्तर और अनुमतियाँ स्पष्ट रूप से निर्धारित की गई हैं।
- बहुस्तरीय सुरक्षा (Multi-Layered Security): मोबाइल उपकरणों पर, डेटा के प्रसारण के दौरान तथा उसके भंडारण के समय सुरक्षा प्रदान करने के लिए बहुस्तरीय सुरक्षा व्यवस्था अपनाई गई है। इससे डेटा जीवनचक्र के प्रत्येक चरण में सुरक्षा सुनिश्चित करने में सहायता मिलती है।
- मोबाइल उपकरणों पर डेटा का सुरक्षित भंडारण (Secure Data Storage on Mobile Devices): एकत्र किए गए डेटा को मोबाइल उपकरणों में सहेजने से पहले एन्क्रिप्ट (कूटबद्ध) किया जाता है। इसके साथ उचित दिनांक और समय की मुहर (Timestamp) भी दर्ज की जाती है, जिससे डेटा की गतिविधियों का पता लगाने और जवाबदेही सुनिश्चित करने में सहायता मिलती है।
- डेटा का स्वचालित निष्कासन (Automatic Data Removal): ORGI सर्वर पर डेटा सफलतापूर्वक प्रेषित हो जाने के बाद, पूर्वनिर्धारित अवधि पूरी होने पर उसे मोबाइल उपकरण से स्वचालित रूप से हटा दिया जाता है। इससे अनधिकृत पहुँच और डेटा के उजागर होने का जोखिम कम होता है।
- व्यापक ऑडिट ट्रेल (Comprehensive Audit Trails): डेटा तक पहुँच तथा उससे संबंधित गतिविधियों के विस्तृत लॉग (अभिलेख) बनाए रखे जाते हैं। इनसे निगरानी, गतिविधियों का पता लगाने, जवाबदेही सुनिश्चित करने और सुरक्षा ऑडिट करने में सहायता मिलती है।
- डेटा का संग्रहित अवस्था और प्रसंस्करण के दौरान एन्क्रिप्शन (Encryption of Data at Rest and During Processing): ORGI के सर्वरों पर संग्रहीत डेटा को एन्क्रिप्टेड अर्थात कूटबद्ध रूप में रखा जाता है। प्रसंस्करण के लिए आवश्यकतानुसार डेटा को मेमोरी में डिक्रिप्ट (कूटमुक्त) किया जाता है। प्रसंस्करण पूरा होने के बाद, उपयोगकर्ताओं की पहुँच के लिए डेटा को डिक्रिप्टेड रूप में संग्रहीत नहीं रखा जाता है।
- बैकअप और आपदा पुनर्प्राप्ति (Backup and Disaster Recovery): अप्रत्याशित परिस्थितियों में डेटा की सुरक्षा और कार्यों की निरंतरता सुनिश्चित करने के लिए, डेटा प्रसंस्करण एवं सुरक्षित भंडारण में उपयोग किए जाने वाले सर्वर और स्टोरेज सिस्टम दिल्ली, बेंगलुरु तथा लखनऊ स्थित तीन डेटा केंद्रों में स्थापित किए गए हैं। यह वितरित अवसंरचना डेटा संरक्षण, बैकअप और आपदा की स्थिति में डेटा एवं सेवाओं की पुनर्प्राप्ति में सहायता करती है।
- उन्नत सुरक्षा निगरानी एवं खतरे की रोकथाम (Advanced Security Monitoring and Threat Prevention): ORGI के डेटा केंद्रों और उनकी सूचना परिसंपत्तियों को अत्यधिक मात्रा में उत्पन्न नेटवर्क ट्रैफिक से होने वाले हमलों (Volumetric Attacks), नेटवर्क में अनधिकृत घुसपैठ, SQL इंजेक्शन, क्रॉस-साइट स्क्रिप्टिंग (XSS), डेटा लीक होने तथा अनधिकृत पहुँच जैसे साइबर खतरों से सुरक्षित रखने के लिए, ORGI ने तीनों डेटा केंद्रों में समर्पित सुरक्षा संचालन केंद्र (Security Operations Centre — SOC) स्थापित करने तथा सुरक्षा सूचना एवं घटना प्रबंधन (Security Information and Event Management — SIEM) की क्षमताएँ विकसित करने की योजना बनाई है। इसके लिए उपयुक्त हार्डवेयर एवं सॉफ्टवेयर आधारित सुरक्षा उपकरणों की व्यवस्था भी की जाएगी।
इन व्यापक सुरक्षा उपायों के माध्यम से, ORGI का उद्देश्य एक सुरक्षित, सुदृढ़ और विश्वसनीय डेटा परिवेश बनाए रखना तथा डेटा के संपूर्ण जीवनचक्र के दौरान संवेदनशील जानकारी की सुरक्षा सुनिश्चित करना है।
2011 की जनगणना
2011 की जनगणना के लिए प्रौद्योगिकी विकल्प 36 माइक्रोसॉफ्ट विंडोज 2008आर2 सर्वर, एसक्यूएल सर्वर -2008, विंडोज 7 प्रोफेशनल क्लाइंट, हाई स्पीड हेवी ड्यूटी डुप्लेक्स स्कैनर (कोडक) और बैकअप एचपी स्टोरेज वर्क्स ईवीए 6400, क्षमता - स्थापित करके 18 डेटा केंद्रों पर आईटी संसाधनों का निर्माण किया गया था। 10/100 टीबी। उपरोक्त हार्डवेयर और सॉफ्टवेयर के अलावा जनगणना-2011 की चुनौतियों का सामना करने के लिए एक इंटेलिजेंट कैरेक्टर रिकग्निशन (आईसीआर) सॉफ्टवेयर ईफ्लो4.5 भी स्थापित किया गया है। लगभग 1200 तकनीकी अधिकारी और लगभग 500 संविदात्मक ऑपरेटरों को 18 डेटा केंद्रों पर इलेक्ट्रॉनिक रूप से डेटा कैप्चर करने और डीपी डिवीजन, नई दिल्ली में जनगणना डेटा के प्रसंस्करण के लिए लगाया गया था। शेड्यूल को स्कैन करने के बाद आईसीआर तकनीक का उपयोग और कंप्यूटर असिस्टेड कोडिंग (सीएसी) का उपयोग बचाता है। क्षेत्रीय सारणीकरण कार्यालयों की स्थापना पर पूर्व में किए गए बहुत सारे सरकारी व्यय। सिस्टम इंटीग्रेटर की सेवाओं का उपयोग 18 डेटा केंद्रों में स्कैनिंग संचालन और डेटा फ़ाइल निर्माण के लिए किया गया था। सभी आवश्यक सॉफ्टवेयर और एमआईएस उपकरण डाटा प्रोसेसिंग डिवीजन, ओआरजीआई, नई दिल्ली के अधिकारियों द्वारा विकसित किए गए हैं।
-
डी.पी. में निम्नलिखित सर्वर हार्डवेयर और भंडारण स्थापित किया गया है। डेटा प्रोसेसिंग गतिविधियों के लिए डिवीजन और भारत में 18 नंबर डेटा केंद्रों में-:
- HP ProLiant DL380G6 क्वाड कोर बेस सर्वर
- HP स्टोरेज वर्क्स EVA6400, क्षमता - 10/100 TB
- कोडक हाई स्पीड स्कैनर्स
2001 की जनगणना
२००१ की जनगणना में, १५ डाटा केंद्रों और डीपी डिवीजन, नई दिल्ली में बड़े पैमाने पर हार्डवेयर उन्नयन किया गया था। यह "इंटेलिजेंट कैरेक्टर रिकॉग्निशन (ICR)" तकनीक का उपयोग करते हुए नवीनतम "ऑटोमैटिक फॉर्म प्रोसेसिंग टेक्नोलॉजी" का उपयोग करने के लिए आवश्यक था। ओएमआर/ओसीआर/आईसीआर प्रौद्योगिकियों का मूल्यांकन किया गया था और आईसीआर को जनगणना डेटा प्रोसेसिंग गतिविधियों के लिए व्यवहार्य समाधान के रूप में स्वीकार्य पाया गया था। 45 एनटी सर्वर, 1060 पीआईआईआई पीसी, 25 हाई स्पीड हेवी ड्यूटी डुप्लेक्स स्कैनर (कोडक) स्थापित करके 15 डेटा केंद्रों पर आईटी संसाधन बनाए गए और ज़िप एसएलआर और डीएलटी ड्राइव जैसे बैकअप डिवाइस का इस्तेमाल किया गया। डीपी डिवीजन, मुख्यालय, ओआरजीआई, नई दिल्ली में 15 डेटा केंद्रों पर इलेक्ट्रॉनिक रूप से डेटा कैप्चरिंग और जनगणना डेटा के प्रसंस्करण के लिए लगभग 1200 तकनीकी अधिकारी और लगभग 500 संविदात्मक ऑपरेटरों को लगाया गया था। स्कैनिंग और डेटा फ़ाइल निर्माण गतिविधियों के लिए पेपर शेड्यूल को निकटतम आवंटित डेटा सेंटर (परिणामस्वरूप परिवहन लागत में कमी) के लिए ले जाया गया था। स्कैनिंग गतिविधियां 24x7x30 आधार पर की गईं। प्रौद्योगिकी ने शत-प्रतिशत डेटा के प्रसंस्करण को सक्षम किया, यानी जनगणना के इतिहास में पहली बार एक बिलियन से अधिक रिकॉर्ड (228 मिलियन पेपर फॉर्म स्कैन किए गए) थे। स्कैन की गई छवियों को स्थायी भंडारण के लिए संग्रहीत किया गया था। कुछ क्षेत्रों के लिए इमेज इनेबल्ड कंप्यूटर असिस्टेड कोडिंग (CAC) लागू की गई थी। अनुसूचियों को स्कैन करने के बाद आईसीआर प्रौद्योगिकी के उपयोग और सीएसी के उपयोग (मैनुअल कोडिंग के लिए क्षेत्रीय सारणीकरण केंद्रों की स्थापना को समाप्त कर दिया गया) ने क्षेत्रीय सारणीकरण कार्यालयों की स्थापना पर पूर्व में किए गए खर्च को बचाया। एक सिस्टम इंटीग्रेटर की सेवाओं का उपयोग 15 डेटा केंद्रों पर स्कैनिंग संचालन और डेटा फ़ाइल निर्माण के लिए किया गया था। प्रौद्योगिकी के उपयोग ने ओआरजीआई के ईडीपी अधिकारियों के कौशल को बढ़ाने में मदद की है। डीपी डिवीजन के अधिकारियों ने डेटा प्रोसेसिंग सॉफ्टवेयर इन-हाउस विकसित किया है।
-
डीपी प्रभाग ने डेटा प्रोसेसिंग परियोजनाओं के लिए भारत के महारजिस्ट्रार का कार्यालय के विभिन्न तकनीकी प्रभागों की सहायता की है, जैसे:
- • जिला हैंडबुक तैयार करना (सामाजिक अध्ययन प्रभाग)
- • बड़े आकार के ग्राम अध्ययन डेटा प्रविष्टि और प्रसंस्करण (सामाजिक अध्ययन प्रभाग)
- • 2001 की जनगणना से डेटा का निष्कर्षण और स्लम परियोजना के लिए सारणीकरण (जनगणना प्रभाग)
- • वर्बल औटोपसी के लिए स्कैनिंग और आईसीआर आधारित प्रसंस्करण (विशेष सांख्यिकी प्रभाग)
- • केंद्रीय सांख्यिकी संगठन की 5वीं आर्थिक जनगणना के लिए स्कैनिंग और आईसीआर आधारित प्रसंस्करण।
1991 की जनगणना
1991 की जनगणना के दौरान, भारत के महारजिस्ट्रार का कार्यालय में डाटा प्रोसेसिंग गतिविधियों में व्यापक बदलाव किए गए। भारत के महारजिस्ट्रार का कार्यालय ने डीपी प्रभाग, पुष्पा भवन में मेधा-930 मेन फ्रेम सिस्टम स्थापित करके अपनी कंप्यूटिंग सुविधा स्थापित की थी। 15 डेटा केंद्रों पर सर्वर से जुड़े यूनिक्स ऑपरेटिंग सिस्टम के तहत डंप टर्मिनलों का उपयोग डेटा प्रविष्टि के लिए किए गए थे। दिल्ली में विभिन्न डेटा केंद्रों और कंप्यूटर केंद्रों के बीच डेटा गतिविधि मैग्नेटिक टेप के माध्यम से की गई थी। डेटा प्रविष्टि के लिए आवंटित 15 डेटा केंद्रों में से एक को अनुसूचियां भेजने से पहले डेटा अनुसूचियां को पूरे भारत में विभिन्न क्षेत्रीय सारणी केंद्रों (लगभग 163) पर कोडित किया गया था। मास्टर डेटा फाइल तैयार करना, मूलभूत क्षेत्रों पर डेटा संपादन और निचले स्तर की सारणी को 4 क्षेत्रीय प्रसंस्करण केंद्रों जैसे दिल्ली, भोपाल (मध्य प्रदेश), भुवनेश्वर (ओडिशा) और चेन्नई (तमिलनाडु) में संसाधित किया गया था। सभी क्षेत्रों पर विचार करते हुए प्रमुख संपादन, विभिन्न स्तरों पर सभी तालिकाओं का प्रसंस्करण और सृजन डीपी प्रभाग, भारत के महारजिस्ट्रार का कार्यालय, मुख्यालय में किया गया था। डाटा प्रोसेसिंग प्रभाग, भारत के महारजिस्ट्रार का कार्यालय, मुख्यालय के अधिकारियों द्वारा सभी आवश्यक सॉफ्टवेयर (डेटा सत्यापन, संपादन, प्रसंस्करण और सारणीकरण के लिए) विकसित किए गए थे। पहली बार, 1991 की जनगणना में, डीपी प्रभाग ने प्रकाशन के लिए हिंदी के साथ-साथ अंग्रेजी में सारणी की कैमरा रैडि प्रतियां तैयार की गई। शत-प्रतिशत डाटा लिया गया। श्रमिकों और अनुसूचित जाति/अनुसूचित जनजाति के शत-प्रतिशत डेटा पर प्रसंस्करण किया गया था। अन्य सारणियों के लिए केवल 10 प्रतिशत अभिलेख संसाधित किए गए थे। संपूर्ण जनगणना डेटा प्रसंस्करण गतिविधियों के लिए 15 डेटा केंद्रों के अधिकारियों सहित लगभग 1200 भारत के महारजिस्ट्रार का कार्यालय अधिकारी लगे हुए थे। सॉफ्टवेयर डीपी प्रभाग के अधिकारियों द्वारा इन-हाउस विकसित किया गया था।
1981 की जनगणना
1981 की जनगणना में, भारतीय जनगणना में पहली बार, डेटा प्रविष्टि गतिविधियों को विकेन्द्रीकृत किया गया था और प्रमुख राज्यों में 15 डेटा केंद्र स्थापित किए गए थे, जिनमें एक केंद्र मुख्यालय, भारत के महारजिस्ट्रार का कार्यालय भी शामिल था। प्रत्येक केंद्र को जीसीएस, ईसीआईएल और आईसीटी द्वारा प्रदान की गई "की टू डिस्क" मशीनों का उपयोग करके पेपर-आधारित जानकारी को मशीन-पठनीय रूप में परिवर्तित करने के लिए एक से अधिक राज्यों (संलग्न राज्यों) को आवंटित किया गया था। एनआईसी, नई दिल्ली और क्षेत्रीय कंप्यूटर केंद्र (आरसीसी), चंडीगढ़ में एचपी1000, सीडी-साइबर 730 और एनईसी-1000 कंप्यूटर सिस्टम का उपयोग करके डेटा प्रोसेसिंग किया गया था। भारत के महारजिस्ट्रार का कार्यालय में आंतरिक डाटा प्रोसेसिंग सुविधाएं उपलब्ध नहीं थीं। 15 डेटा केंद्रों में से एक को डेटा प्रविष्टि के लिए अनुसूचियां भेजने से पहले डेटा अनुसूचियां को पूरे भारत में विभिन्न क्षेत्रीय सारणी केंद्रों पर कोडित किया गया था। 15 डेटा केंद्रों के अधिकारियों सहित लगभग 1200 भारत के महारजिस्ट्रार का कार्यालय अधिकारी संपूर्ण जनगणना डेटा प्रोसेसिंग गतिविधियों में लगे हुए थे। डाटा प्रोसेसिंग प्रभाग, भारत के महारजिस्ट्रार का कार्यालय, मुख्यालय के अधिकारियों द्वारा सभी आवश्यक सॉफ्टवेयर (डेटा सत्यापन, संपादन, प्रसंस्करण और सारणीकरण के लिए) विकसित किए गए थे।
1971 की जनगणना
1971 की जनगणना 1872 से लगातार होने वाली जनगणनाओं की श्रृंखला में 11वीं थी। यह सर्वविदित है कि जनगणना के आंकड़ों का प्रसंस्करण जनगणना में बहुत महत्वपूर्ण स्थान रखता है। जनगणना की गणना पूरी तरह से और सटीक हो सकती है लेकिन जब तक आवश्यक डेटा को ठीक से संसाधित नहीं किया जाता है, तब तक जनगणना सारणीकरण सटीक और उपयोगी नहीं होगा। डेटा प्रोसेसिंग के विभिन्न तरीके हैं और एक उपयुक्त पद्धति का चुनाव देश की परिस्थितियों पर निर्भर करता है। 1971 की जनगणना में, अधिकांश सारणियां ग्रामीण आबादी के 10 प्रतिशत नमूने और शहरी आबादी के 20 प्रतिशत नमूने से इलेक्ट्रॉनिक कंप्यूटरों, मुख्य रूप से आईबीएम-1401 की मदद से तैयार की गई थीं।
1961 की जनगणना
1961 की जनगणना में, "यूनिट रिकॉर्ड" मशीनों को अपनाने के साथ एक मामूली शुरुआत की गई थी। 1961 की जनगणना से पहले, डेटा संग्रह, डेटा प्रविष्टि और प्रसंस्करण मैन्युअल रूप से किया जाता था। 1961 की जनगणना में, डेटा को मशीन पठनीय रूप में परिवर्तित करने के लिए 80 कॉलम (होलरिथ) पंच कार्डों का उपयोग करते हुए हैंड पंचिंग मशीन (एक समय में एक कार्ड डालने) का उपयोग किया गया था। संपूर्ण डेटा से चयनित नमूने (डेटा) पर प्रसंस्करण किया गया था। लगभग 70 भारत के महारजिस्ट्रार का कार्यालय अधिकारी डेटा प्रविष्टि, प्रोग्रामिंग और मशीन संचालन में शामिल थे। डेटा प्रविष्टि के लिए अनुसूचियां भेजने से पहले डेटा अनुसूचियां को पूरे भारत के विभिन्न क्षेत्रीय सारणी केंद्रों में कोडित किया गया था। पंच किए गए कार्डों के पूरे सेट की प्रतियां बनाने के लिए रिप्रोड्यूसर का उपयोग किया गया था। सत्यापनकर्ता, सॉर्टर मशीन का उपयोग करके डाटा प्रोसेसिंग किया गया था। "सीरियल रोलिंग टोटल टेबुलेटर कम प्रिंटर (एसआरटीटी)" का उपयोग जनगणना तालिकाओं के सारणीकरण और मुद्रण के लिए किया गया था। उस समय डेटा बैकअप सिस्टम उपलब्ध नहीं था।


 : 5636815